回帰の目的 …… データ集合{xi}から目標{ti}を予測します。
線形基底関数モデル
単純にxiについて線形結合するのは「線形回帰」と呼ばれます。
y(x,w)=w0+w1x1+...+wDxD
ここでは、xi について**非線形な関数の線形結合**を考えましょう。
y(x,w)=w0+j=1∑M−1wjϕj(x)
これは、パラメータwについての線形結合なので「線形モデル」となります!
w0は鬱陶しいので、ϕ0(x)=1 とすれば、
y(x,w)=wTϕ(x)
ただし、
x=⎝⎛x0⋮xD⎠⎞w=⎝⎛w0⋮wM−1⎠⎞ϕ=⎝⎛ϕ0⋮ϕM−1⎠⎞
とします。w0は「バイアスパラメータ」、ϕj(x)は「基底関数」と呼びます。
基底関数の例
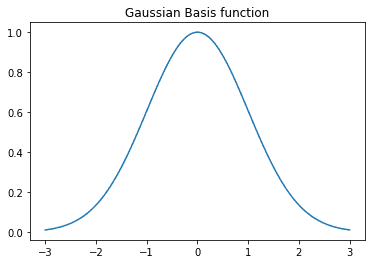
- ガウス基底関数
ϕj(x)=exp{−2s2(x−μ)2}
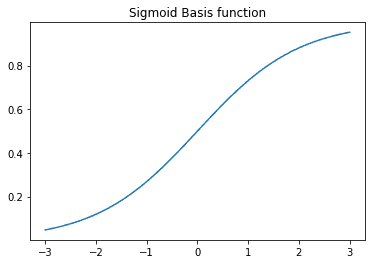
- シグモイド基底関数
ϕj(x)=1+exp(sx−μj)1=σ(sx−μj)
- フーリエ基底関数
ϕj(x)=exp(jnkx)
Gaussian Basis function
import numpy as np

def GBF(x,m,s):
    return np.exp(-(x - m)**2/(2*(s)**2))
Sigmoid Basis fuction
import numpy as np

def SBF(x,m,s):
    return 1 / (1 + np.exp(-(x-m)/s))
最尤推定:最小二乗法で尤もらしい回帰モデルを推定しよう
t=y(x,w)+ε=(決定論的関数)+(ガウスノイズ)
目標変数 t は決定論的関数とガウスノイズの和で表されるとしましょう。
ε∼N(ε∣0,β−1)、つまりガウスノイズは平均 0 分散 β−1 の正規分布に従うので、
p(t∣x,w,β)=N(t∣y(x,w),β−1)
と表されます。また、新たなxnewに対する予測値は、tの条件付き期待値で与えられて、
E[t∣xnew]=∫tp(t∣xnew)dt=y(xnew∣w)
つまり、予測値はxnewを**決定論的関数に代入する**ことで得られます。
次に、データ集合を考えます。
Data={x1,…,xN},t=(t1,...,tN) とするとき、
p(t∣Data,w,β)=n=1∏NN(tn∣wTϕ(xn),β−1)
∴ lnp(t∣w,β)=n=1∑NlnN(tn∣wTϕ(xn),β−1) =2Nlnβ−2Nln(2π)−βED(w)
ただし、最小二乗誤差は、ED(w)=21∑n=1N{tn−wTϕ(xn)}2です。
最尤推定をするために、対数尤度 lnp(t∣w,β) を w について最大化します。
w に依存するのは ED(w) だけなので、これを最小化すればよいでしょう。
∇lnp(t∣w,β)=0∴ βn=1∑N{tn−wTϕ(xn)}ϕ(xn)T=0∴ n=1∑NtnϕT−wT(n=1∑Nϕ⋅ϕT)=0∴ wML=(n=1∑Nϕ⋅ϕT)−1n=1∑Nϕ tn
これは、**正規方程式**と呼ばれ、計画行列 Φ ・ペンローズの疑似逆行列 Φ† を用いて表すことができます。
wML=(ΦTΦ)−1ΦTt=Φ†t
ただし、計画行列 Φ は以下のように定義します。
Φ=⎝⎛ϕ1(x1)⋮ϕ1(xN)…⋱…ϕM−1(x1)⋮ϕM−1(xN)⎠⎞
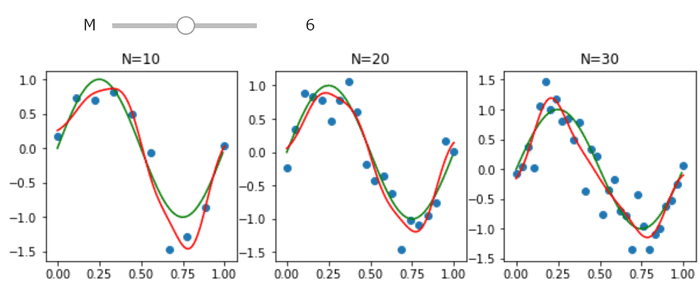
サイン関数+ノイズによって生成されたサンプルに対し最尤推定をしましょう。Pythonによる実装は以下です。
import numpy as np
import matplotlib.pyplot as plt
from numpy.linalg import inv
from ipywidgets import interact
def phi(mus, x):
ret = np.array([np.exp(-(x-mu)**2/(2*0.1**2)) for mu in mus])
ret[0] = 1
return ret
def solve(mus,x_train,y_train,N,m):
PHI = np.array([phi(mus,x) for x in x_train]).reshape(N,m)
w_ml = inv(PHI.transpose().dot(PHI)).dot(PHI.transpose()).dot(y_train)
return w_ml
x_real = np.arange(0, 1, 0.01)
y_real = np.sin(2*np.pi*x_real)
@interact(M=(2,10))
def plot(M):
ary_mu = np.linspace(0,1,M)
f,ax = plt.subplots(1,3,figsize=(10,3))
for i,N in enumerate([10,20,30]):
ax[i].plot(x_real,y_real,'g-')
x_train = np.linspace(0,1,N)
y_train = np.sin(2*np.pi*x_train) + np.random.normal(0,0.3,N)
ax[i].scatter(x_train,y_train,)
w_ml = solve(ary_mu,x_train,y_train,N,M)
x_range = np.linspace(0,1,100)
ax[i].plot(x_range,[phi(ary_mu,x).dot(w_ml) for x in x_range],'r-')
ax[i].set_title('N={}'.format(N))
バイアスパラメータ w0 の役割
ED(w)をw0について最大化してみます。w0を明示すると、
ED(w)=21n=1∑N{tn−w0−j=1∑M−1wjϕj(xn)}2
となるので、∂w0∂ED=0 としたとき、
w0=N1n=1∑Ntn−j=1∑M−1(wjN1n=1∑Nϕj(xn))=tˉ−j=1∑M−1wjϕjˉ
と表されます。したがって、
w0=(目標値の平均)−(基底の平均の重み付き線形和)
となるため、w0 はこの2つの差を埋める働きをしていることがわかります。
ノイズの精度 β の役割
同様に、∂β∂ED=0 としたとき、
βML1=N1n=1∑N{tn−wMLTϕ(xn)}2
と表されます。したがって、
βML1=(残差の分散)
となるため、β は残差の精度を表していることがわかります。
最小二乗法の意味
回帰関数は、M個の基底関数によって作られるM次元空間上の点となります。
よって、最小二乗誤差は、
ED=21∥∥⎝⎛t1⋮tN⎠⎞−⎝⎛y(x1,w)⋮y(xN,w)⎠⎞∥∥2
と表され、目標値と回帰関数の**M次元空間上のユークリッド距離**となります。
逐次学習(オンライン学習)
大規模データの時は、一つずつデータを使ってパラメータを更新していくことが多いです。
このときの更新式は、
w(t+1)=w(t)+η∇En
とすればよいでしょう。この手法は、確率的勾配化法とも呼ばれています。
正則化最小二乗法
ΦTΦ が非正則に近いとき、逆行列が計算しにくくなり正規方程式が不安定となってしまいます。
これを防ぐために、誤差関数に正則化項を追加して正規性を保つようにすることがあります。
二乗誤差では、
E=21n=1∑N{tn−wTϕ(xn)}2+2λw⋅wT
という誤差を代わりに用います。このときの最尤推定値は、
wML=(λI+ΦTΦ)−1ΦTt
となります。この手法は「荷重減衰」や「パラメータ縮小推定」と呼ばれています。
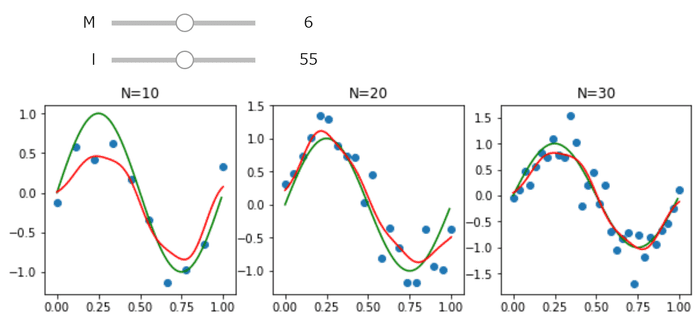
前回の手法に正則化項を加えましょう。Pythonによる実装は以下です。
def phi(mus, x):
ret = np.array([np.exp(-(x-mu)**2/(2*0.1**2)) for mu in mus])
ret[0] = 1
return ret
def solve(mus,x_train,y_train,N,m,l_):
PHI = np.array([phi(mus,x) for x in x_train]).reshape(N,m)
w_ml = inv(l_*np.identity(m)+PHI.transpose().dot(PHI)).dot(PHI.transpose()).dot(y_train)
return w_ml
x_real = np.arange(0, 1, 0.01)
y_real = np.sin(2*np.pi*x_real)
@interact(M=(2,10),l=(10,100))
def plot(M,l):
ary_mu = np.linspace(0,1,M)
l *= 0.01
f,ax = plt.subplots(1,3,figsize=(10,3))
for i,N in enumerate([10,20,30]):
ax[i].plot(x_real,y_real, 'g-')
x_train = np.linspace(0,1,N)
y_train = np.sin(2*np.pi*x_train) + np.random.normal(0,0.3,N)
ax[i].scatter(x_train,y_train,)
w_ml = solve(ary_mu,x_train,y_train,N,M,l)
x_range = np.linspace(0,1,100)
ax[i].plot(x_range,[phi(ary_mu,x).dot(w_ml) for x in x_range],'r-')
ax[i].set_title('N={}'.format(N))
Reference
- Bishop, Christopher M. Pattern recognition and machine learning. springer, 2006.
